もう「使われない箱」とは呼ばせない!
AIで変わるデータ基盤の構築とナレッジマネジメント
この記事の要約
本記事では、生成AIを前提としたデータ基盤構築と分析ナレッジのマネジメントについて解説します。サンドボックスで素早く分析・検証し、価値が確認されたデータを正式な基盤へ取り込む進め方、ナレッジカタログの整備、ナレッジスチュワートの役割を紹介します。
この記事を読むとわかること
- AIによってデータ基盤の構築・活用のあり方が変わる理由
- サンドボックスを活用したAI時代のデータ基盤構築の進め方
- AI時代に分析ナレッジのマネジメントが必要な理由
- ナレッジカタログの整備方法とナレッジスチュワートの役割
今回は、AIを活用したデータ基盤構築の要諦をご説明します。
AIが実現する「使われないデータ基盤」からの脱却
DX・データドリブン経営への要請を受け、多くの企業では、IT部門やDX関連部署が主導して、データ基盤の構築を進めてきました。しかし、日常的に基盤を活用するユーザーが思うように増えず、「業務側を巻き込んだ活動にならない」、「成果のわりにコストが高い」と、PoC止まりのケースが少なくありませんでした。
一部の熱心なユーザーから、新たな活用の要望が寄せられるものの、ETL/DB構築・BIの開発リードタイムの長さが利用拡大の障壁となりました。その結果、当初は全社的なデータ活用を目指していたにもかかわらず、活用が広がらないまま取り組みが停滞してしまい、データ基盤は存在するものの、使われない「箱」となっている企業も少なくありませんでした。
しかし、生成AIの登場によって、データ基盤の構築から活用までのあり方は大きく変わり始めています。
例えば、先進企業では、現場の担当者から経営層までが自然言語でAIに問いかけ、AIがデータ基盤内のデータの抽出・加工・分析を行っています。従来のように、経営企画や経理に分析依頼して回答を待ったり、特殊なデータ抽出を情報システム部門やベンダーに依頼したりする必要も大幅に減っています。
こうした企業では、ユーザーが一気に増え、そのユーザーから次々と新たなデータソースの追加要望が寄せられ、データ基盤を担うチームがそれらを短期間でサンドボックス環境へ取り込み、すぐに分析へ利用できるようにする、といったサイクルが生まれています。
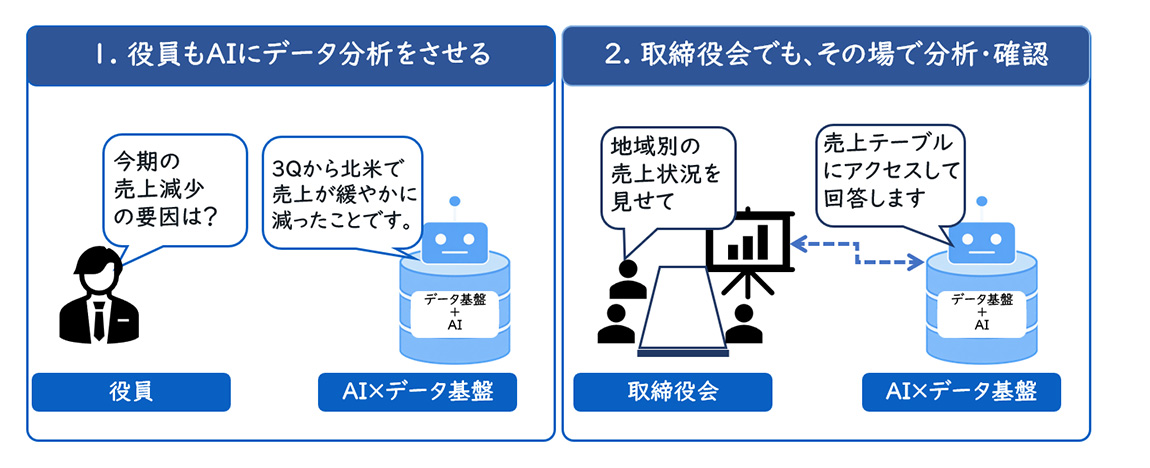
【図1】役員・取締役会を支えるAI+分析基盤
I/F構築の前に、使えそうなデータをサンドボックスへ
従来のデータ基盤構築では、基幹システムや周辺システムとのI/F(インターフェース)を設計し、データ連携やデータモデルを整備したうえで、BIを構築してユーザーへ提供するという進め方が一般的でした。
しかし、このアプローチには大きな課題があります。
実際にどのデータが使われるのか分からない段階で、時間とコストをかけてデータ連携やデータモデルを作り込んでしまうことです。さらに、I/F、データレイク、DWH、データマート、BIと順に開発するため、ユーザーがデータを利用できるまでに長いリードタイムを要します。
AIによるデータ活用を前提とすると、この順序を逆転させることができます。
まず、使う可能性のあるデータを各システムからCSV等のファイル形式で抜き出し、最低限のデータ定義やテーブル間のリレーションなどのメタデータを設定して、サンドボックス環境へロードします。サンドボックス環境とは、本番の業務システムや正式なデータ基盤とは切り離した、検証用のデータ活用環境を指します。
つまり、最初から完全なデータ品質や厳密なデータモデル、定常的なETLロジックやBI画面を作るのではなく、まずユーザーがAIを介して分析・仮説検証できる状態を素早く作ることを優先するのです。
そのうえで、実際に利用頻度が高く、業務上の価値が確認されたデータから、正式なI/Fを構築し、データ品質を確保したうえでデータモデルを整備して、本番のデータ基盤へ取り込んでいきます。データマートやBIの開発についても、この時点ではすでにユーザーがAIと一緒に分析・可視化をしているため、さまざまなパターンを検討した結果、「定常的にどう見たいか?」、「その分析はどういう計算か?」という確実で、具体的な要件が固まっています。
従来の「使われることを想定して先に作り込む」方式から、「まず使い、価値が確認されたものから作り込む」方式へ転換することが、AI時代のデータ基盤構築では重要になります。
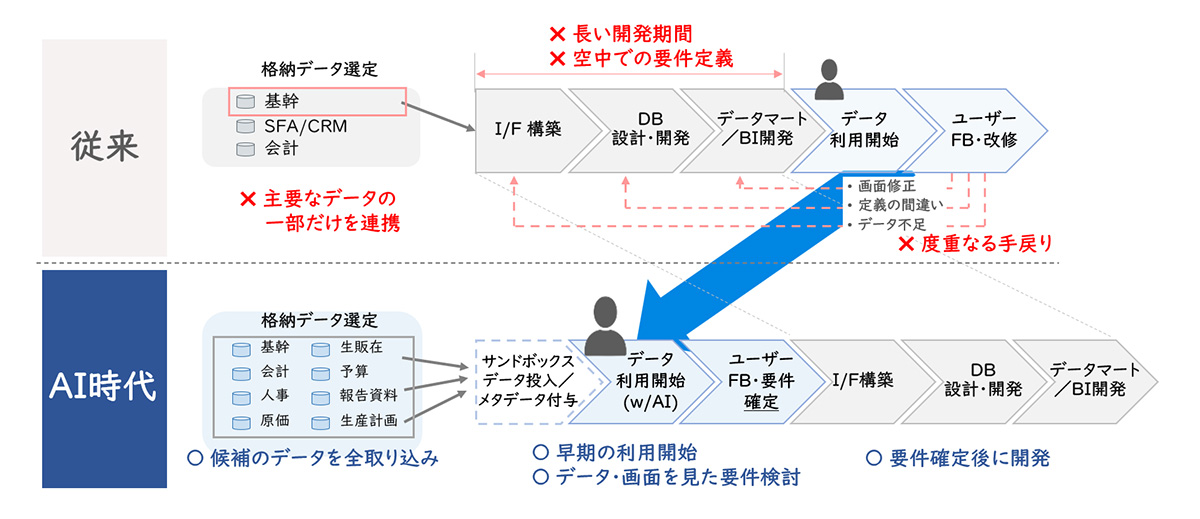
【図2】AIによって変わるデータ基盤の開発プロセス
AI時代は、データのマネジメントから「分析ナレッジ」のマネジメントへ
AI時代には、データマネジメントも大きく変わります。これまでは、データを利用する別の誰かが見ても正しく理解・分析できるよう、データを整理・モデリングし、定義を付与することが求められてきました。
しかし、AI時代では、データカタログやメタデータの登録は、元データの設計書・定義書などの元情報をAIに与えることで、登録作業を効率化できます。データモデリングについても、これまでは人間が理解・分析しやすいよう時間をかけて整えてきましたが、多少冗長で整理されていない構造であっても、AIがその意味や関係性を正しく理解できれば支障はなくなります。
むしろ重要になるのは、分析ナレッジをAIが利用できる形にし、全社で蓄積・更新していくことです。
売上の予実分析ひとつとっても、為替レートや値引き・返品の考慮、生産キャパ、内部取引の消去要否、新商品・終売の考慮、価格改定の折り込み要否といった前提を確認し、分析目的に合わせて製品別や地域別、売り先別に補正ロジックを入れているはずです。
これまで、こうした処理の多くは、経営企画・経理担当者のExcelや分析手順、あるいは担当者自身の経験の中に存在し、役員には補正後の数字だけが提示されていました。しかし、データ基盤に接続されたAIに直接分析を依頼するようになると、人が暗黙のうちに行っていた判断や補正も、AIが利用できる形で明示する必要があります。
どれほど優れた経営者が、鋭い仮説を立て、高度なAIを使って精緻なシミュレーションを行ったとしても、「どのデータを、どのような前提で組み合わせ、どのように補正して分析するか」が誤っていれば、もっともらしい誤った結論を精緻化するだけです。
何を補正し、何を除外し、どの切り口で評価するのかという「正しい分析の作法」は、企業・事業ごとに異なります。これまで人に埋め込まれていたこうした分析ナレッジを明示化し、AIが利用できる形で蓄積し、会社として認定・更新していくことが、AI時代の新たなマネジメント対象になります。
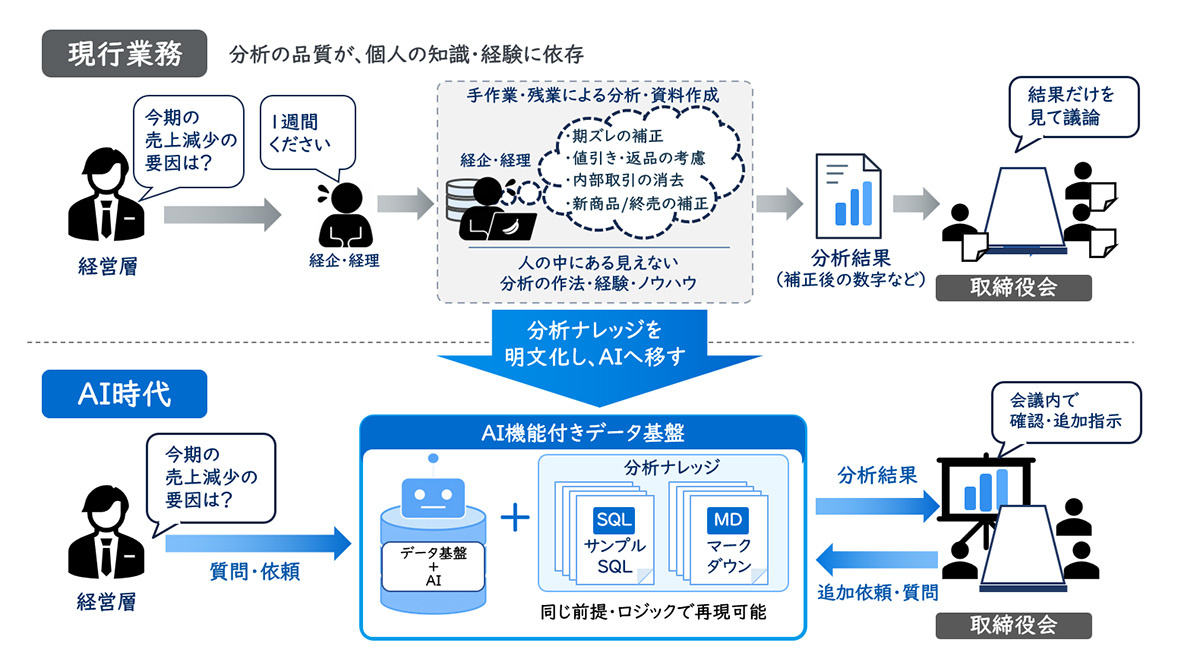
【図3】分析ナレッジのマネジメントの必要性
データカタログより「ナレッジカタログ」を作り込む
前章の補正ロジックをどのように蓄積したらよいでしょうか?
ChatGPTやClaudeには、特定のタスクの実行方法を再利用可能な形で定義する「Skills」という仕組みがあります。SKILL.mdを中心に、指示や例、必要に応じてコードなどをまとめておくことで、長いプロンプトを都度記述しなくても、同じタスクを一定の手順で実行できます。
これと同じ発想で、分析方法や業務固有のルールを管理・蓄積する仕組みがDatabricksやSnowflakeにも実装されています。
例えば、Databricksでは、指標や分析軸に関するナレッジはSQLで表現する「SQL expressions」に、複雑な分析方法は「Example SQL」として、過去の分析例を蓄積できます。加えて、文章で補足すべきルールは「Instructions」としてテキストで表現して、AIに参照させることができます。
Snowflakeでも、Semantic Viewsに指標や分析軸などのビジネス定義を持たせるとともに、Verified Query Repositoryに検証済みの質問とSQLを蓄積し、類似する分析に再利用できる仕組みが提供されています。
※機能名称が定期的に変更となる場合があります。
今後はデータカタログのメンテナンスを可能な限り生成AIに任せ、人が時間をかける対象を、分析ナレッジの整備へと移していく必要があります。
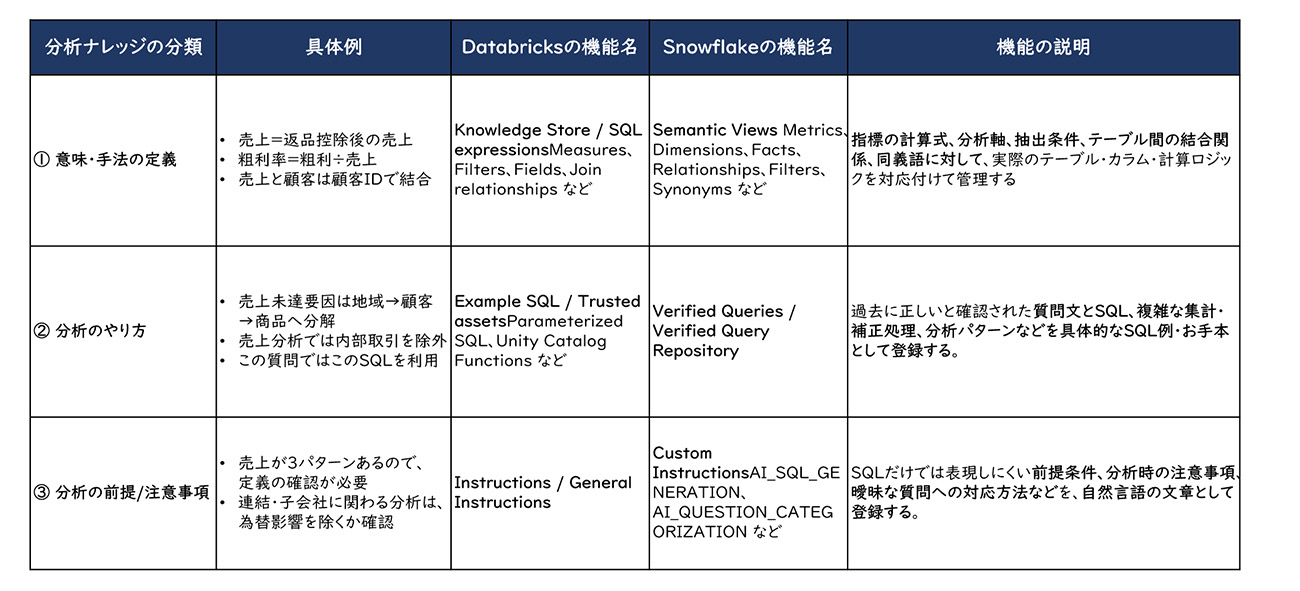
【図4】主要データ基盤におけるナレッジマネジメント機能
データスチュワートから「ナレッジスチュワート」へ
これまで企業では、データの定義や品質、アクセス権を管理する「データスチュワート」を各業務領域に置いてきました。AI時代には、データスチュワートの機能を可能な限りAIに任せ、人間は、分析の前提や方法を管理する「ナレッジスチュワート」として分析ナレッジのマネジメントを行う必要があります。 ナレッジスチュワートも従来のデータスチュワートと同様に、原価、予実管理、連結、生産といったテーマごとに配置し、それぞれの領域を理解した専門家が分析ナレッジの正しさや更新に責任を持つ体制が求められます。
ナレッジスチュワートは、自ら先頭に立ってAIを使って分析を行いながら、そこで得られた分析の前提や方法をAIに教え込んでいきます。同時に、周囲のユーザーによる分析の利用ログにも目を配り、誤った分析方法を把握するとともに、優れた分析方法を発見した場合には、「認定済み」の分析ナレッジとして追加登録し、継続的に見直し・更新していく役割を担います。
もちろん、このナレッジの発見や棚卸しをすべて人手で行う必要はありません。AIが利用ログや過去の分析を探索し、新たなナレッジ候補や、既存ナレッジとの乖離、陳腐化した可能性のあるルールをナレッジスチュワートに提示することもできます。
こうして、人間が正しい分析の作法を定義し、AIがその発見・適用・更新を支援する。 AIと人間が協働しながら企業固有の分析ナレッジを継続的に蓄積・高度化していくことが、AI時代のデータ活用を支える新たな仕組みになるのです。
レイヤーズ・コンサルティングでは、データ基盤の構想・構築だけでなく、経営管理や業務分析、データマネジメントに関する知見を組み合わせ、AIを前提としたデータ活用の高度化をご支援しています。データを「ためる」だけでなく、どのデータを、どのような前提・ロジックで分析するのかという企業固有のナレッジまで整理し、AIが継続的に活用できる仕組みづくりから、運用体制・ナレッジスチュワートの設計まで一貫して支援いたします。
まとめ
生成AIの登場により、データ基盤は単にデータを蓄積し、決められたレポートを提供するための仕組みから、経営層や業務部門がAIと対話しながら、実績把握、要因分析、仮説検証、将来シミュレーションを行うための実践的な基盤へと変わり始めています。
これからのデータ基盤構築では、最初から完全なI/Fやデータモデル、BI画面を作り込むのではなく、まず使えそうなデータをサンドボックス環境に取り込み、AIを介して素早く分析・検証し、業務上の価値が確認されたデータから正式な基盤へ取り込んでいく進め方が重要になります。
同時に、AI時代のデータ活用で本当に差がつくのは、データそのものの整備だけではありません。どのデータを、どのような前提で組み合わせ、どの補正ロジックを用いて分析するのかという、企業固有の「分析ナレッジ」をいかに蓄積・更新し、AIが利用できる形にしていくかが問われます。データカタログやメタデータの整備は生成AIに任せられる領域が広がる一方、人間は、正しい分析の作法を定義し、検証し、認定済みのナレッジとして管理する「ナレッジスチュワート」としての役割を担う必要があります。
つまり、AI時代のデータ活用とは、「人がデータを探し、人が集計し、人が分析する」世界から、「AIがデータを理解し、分析ナレッジに基づいて判断材料を提示し、人間が意思決定する」世界への転換です。データ基盤を“使われない箱”で終わらせないためには、基盤構築、データマネジメント、分析ナレッジの整備、運用体制の設計を一体で進めることが不可欠です。
レイヤーズ・コンサルティングでは、経営管理・業務分析・データマネジメントの知見を組み合わせ、AIを前提としたデータ基盤構想、サンドボックスを活用した段階的な基盤構築、分析ナレッジの整理、ナレッジスチュワートを含む運用体制設計まで一貫してご支援しています。
AIによるデータ活用を、単なる実証実験やツール導入で終わらせず、経営と現場の意思決定を高度化する仕組みとして定着させたい企業様は、ぜひお気軽にご相談ください。
オンライン相談問い合わせる メルマガ登録
最新情報をお届け! メルマガ登録
この記事の執筆者
-
 大橋 遊経営管理事業部
シニアマネージャー -
 鎌苅 俊太経営管理事業部
シニアコンサルタント
職種別ソリューション